 Haris Odobasic
Wil je een CRM bijwerken zonder duplicaten te maken, match dan elk nieuw record met wat al in het CRM staat voordat je importeert, en importeer de matches daarna als updates op basis van het record-ID uit het CRM. Als bedrijfsnamen niet exact overeenkomen, doet een kort Python-script met fuzzy matching (pandas plus RapidFuzz) dit in minder dan een minuut voor tienduizenden rijen.
Python kan goed van pas komen in Revenue Operations. Ik gebruik het graag als ik met data aan de slag moet. Zo ziet GTM engineering er ook dagelijks uit, met een kleine, specifieke tool die handwerk wegneemt en de data beschermt die elk rapport, elke forecast en elke AI-agent leest.
Waarom je spreadsheet crasht als je 30k accounts met een CRM matcht
Onlangs moesten we een lijst van 30k accounts matchen met een CRM dat al 10k accounts had. Je kunt erop rekenen dat er heel veel duplicaten waren.
Het grootste probleem was dat het CRM vaak de merknaam gebruikte (The Lego Group), terwijl het nieuwe bestand alleen juridische namen had (Lego A/S). Balen.
Dat betekent 300 miljoen mogelijke paren vergelijken. Daar lopen spreadsheettools als Excel of Google Sheets op vast (bij mij in elk geval wel).
Tip: Zorg dat je dataset in de best mogelijke staat is voordat je data in het CRM importeert. Zodra het in het CRM staat, kosten correcties veel meer tijd (en geld). Een snelle zelfcheck zoals ons RevOps-data-assessment laat zien waar je staat.
Waarom Python en AI voor het matchen van CRM-data
Even raden. Python klinkt intimiderend? Dat dacht ik ook. Mijn code is verre van perfect. Toch is het nu makkelijker te leren dan ooit, en AI-assistenten zoals ChatGPT veranderen alles. In een paar maanden leer je genoeg om het te gebruiken voor zakelijke toepassingen zoals fuzzy matching. Ons AI-playbook voor sales en RevOps laat zien waar AI nog meer oplevert.
Hoe fuzzy matching dubbele bedrijfsnamen vindt
Je hebt de twee bestanden nodig die je wilt matchen. In ons geval waren dat deze.
- Bestand 1 is de export uit het CRM, inclusief het record-ID.
- Bestand 2 is de nieuwe data van de dataleverancier.
Tip: Zorg dat er binnen elk bestand geen duplicaten zitten. Het script waarschuwt je als het die vindt.
Matchvariabele. Elk bestand heeft een kolom nodig om op te matchen. In ons voorbeeld hebben beide een kolom "Account Name". Verschillen de kolomnamen tussen de bestanden, dan stel je ze elk apart in als je het script draait.
Fuzzy matching. Fuzzy matching is een methode om strings bij benadering te matchen. Simpel gezegd matcht het woorden die op elkaar lijken, zoals in de afbeelding hieronder.
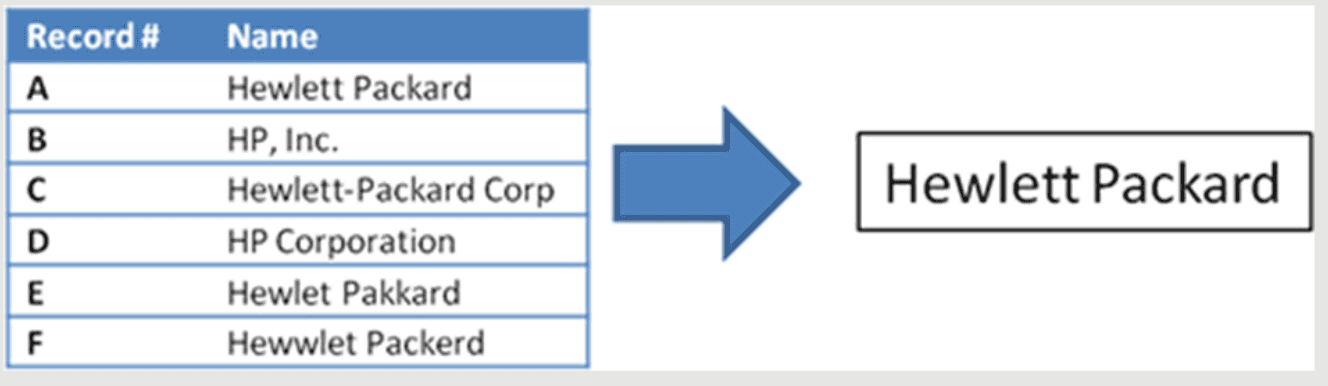
Hier vind je een uitgebreide uitleg van het concept.
Voor ons doel hoef je alleen te weten dat een fuzzy match een drempel voor gelijkenis nodig heeft. Het percentage vertelt het script hoe sterk twee namen op elkaar moeten lijken om als match te tellen.
- Te hoog, bijvoorbeeld 97%, en je mist echte matches.
- Te laag, bijvoorbeeld 84%, en je krijgt meer foute matches.
Een goede richtlijn is 90 tot 95%. Het script gebruikt 90 voor een match en behandelt 80 tot 90 als "review", zodat een mens naar de grensgevallen kijkt in plaats van dat het script gokt.
Je kunt onder de 90 gaan, maar doe dan een paar testruns en controleer de resultaten handmatig op vreemde matches. Het hangt allemaal af van je brondata.
Normaliseer eerst. Voordat het script vergelijkt, zet het namen in kleine letters, haalt het leestekens weg en laat het rechtsvormen en opvulwoorden vallen (Ltd, GmbH, B.V., A/S, Group, The). Deze stap doet het meeste werk. Sinds versie 3.0 bewerkt RapidFuzz strings standaard niet meer vooraf, dus het script doet dat expliciet.
Zo ziet dat eruit voor de namen in de afbeelding, door het script gehaald tegen één CRM-record met de naam "Hewlett Packard".
| Nieuwe naam | Score | Status |
|---|---|---|
| Hewlett-Packard Corp | 100 | match |
| Hewlet Pakkard | 89,7 | review |
| Hewwlet Packerd | 86,7 | review |
| HP, Inc. | geen match | new |
| HP Corporation | geen match | new |
Fuzzy matching vangt typfouten en juridische toevoegingen op. Het weet niet dat HP en Hewlett Packard hetzelfde bedrijf zijn. Daar zijn domeinen voor.
Op welke velden je matcht om duplicaten te voorkomen
| Matchen op | Sterkte | Opmerkingen |
|---|---|---|
| Websitedomein | Sterkst | HubSpot ontdubbelt bedrijven zelf op domeinnaam en contacten op e-mailadres |
| KvK- of btw-nummer | Sterk | Betrouwbaar als je dataleverancier het aanlevert |
| Genormaliseerde naam plus land | Goed | Wat dit script doet; voeg het land toe om bedrijven met dezelfde naam te onderscheiden |
| Alleen naam | Zwakst | Gebruik de reviewcategorie en controleer handmatig |
Volledig Python-script voor fuzzy matching van CRM-accounts
Je hoeft maar een paar opties in te stellen als je het draait.
- de twee bestandspaden
- de matchkolom in elk bestand (standaard "Account Name")
- de kolom met het CRM-record-ID (standaard "Record ID")
- de matchdrempel en de ondergrens voor review (standaard 90 en 80)
Installeer de twee libraries eenmalig met pip install pandas rapidfuzz, en draai daarna het script hieronder.
python match_accounts.py crm_accounts.csv new_accounts.csv --crm-column "Account Name" --new-column "Account Name"
Het script schrijft matches.csv met één rij per nieuw account. Daarin staan de beste match in het CRM, het record-ID, de score en een status (match, review of new).
"""Match a new account list against your CRM before import, so you update instead of duplicating.

Usage:
    python match_accounts.py crm_accounts.csv new_accounts.csv \
        --crm-column "Account Name" --new-column "Account Name" \
        --crm-id-column "Record ID" --threshold 90 --review-floor 80

Output: matches.csv with one row per new account and a status column:
    match  = score >= threshold: update the existing CRM record (use its record ID)
    review = score between review-floor and threshold: a human decides
    new    = no good match: import as a new record
"""
import argparse
import re

import pandas as pd
from rapidfuzz import fuzz, process, utils

DROP_TOKENS = {  # legal forms and filler words that make the same company look different
    # extend this set for the countries you sell into
    "the", "inc", "ltd", "llc", "plc", "corp", "corporation", "co", "company",
    "limited", "group", "holding", "holdings", "gmbh", "ag", "bv", "nv",
    "sa", "sas", "srl", "spa", "as", "aps", "ab", "oy", "kg",
}


def normalise(name):
    """Lowercase, strip punctuation and legal forms: 'Lego A/S' and 'The LEGO Group' both become 'lego'."""
    if pd.isna(name):
        return ""
    tokens = utils.default_process(str(name)).split()
    merged, letters = [], ""
    for token in tokens:  # glue initials back together: 'b v' -> 'bv', 'a s' -> 'as'
        if len(token) == 1:
            letters += token
            continue
        if letters:
            merged.append(letters)
            letters = ""
        merged.append(token)
    if letters:
        merged.append(letters)
    kept = [t for t in merged if t not in DROP_TOKENS]
    return " ".join(kept) if kept else " ".join(merged)


def main():
    parser = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
    parser.add_argument("crm_file", help="CSV export from your CRM (must include the record ID)")
    parser.add_argument("new_file", help="CSV with the new accounts you want to import")
    parser.add_argument("--crm-column", default="Account Name")
    parser.add_argument("--new-column", default="Account Name")
    parser.add_argument("--crm-id-column", default="Record ID")
    parser.add_argument("--threshold", type=float, default=90)
    parser.add_argument("--review-floor", type=float, default=80)
    parser.add_argument("--encoding", default="utf-8-sig", help="try ISO-8859-1 if the export has odd characters")
    parser.add_argument("--out", default="matches.csv")
    args = parser.parse_args()

    crm = pd.read_csv(args.crm_file, encoding=args.encoding, dtype=str)
    new = pd.read_csv(args.new_file, encoding=args.encoding, dtype=str)
    for df, col, label in ((crm, args.crm_column, "CRM file"), (new, args.new_column, "new file")):
        if col not in df.columns:
            raise SystemExit(f"Column '{col}' not found in the {label}. Columns: {list(df.columns)}")

    crm["_key"] = crm[args.crm_column].map(normalise)
    new["_key"] = new[args.new_column].map(normalise)

    # Duplicates inside each file come first: fix them before matching across files.
    for df, label in ((crm, "CRM file"), (new, "new file")):
        dupes = df[df["_key"].ne("") & df.duplicated("_key", keep=False)]
        if len(dupes):
            print(f"Warning: {len(dupes)} rows in the {label} share a normalised name with another row.")

    choices = crm["_key"].tolist()
    rows = []
    for _, record in new.iterrows():
        best = None
        if record["_key"]:
            # extractOne runs in C++ and stops early below score_cutoff
            best = process.extractOne(record["_key"], choices, scorer=fuzz.token_sort_ratio,
                                      score_cutoff=args.review_floor)
        if best:
            _, score, position = best
            status = "match" if score >= args.threshold else "review"
            crm_name = crm.at[position, args.crm_column]
            crm_id = crm.at[position, args.crm_id_column] if args.crm_id_column in crm.columns else ""
        else:
            score, status, crm_name, crm_id = 0, "new", "", ""
        rows.append({
            "new_name": record[args.new_column],
            "crm_match": crm_name,
            "crm_record_id": crm_id,
            "score": round(score, 1),
            "status": status,
        })

    result = pd.DataFrame(rows)
    result.to_csv(args.out, index=False)
    print(result["status"].value_counts().to_string())
    print(f"Saved {len(result)} rows to {args.out}")


if __name__ == "__main__":
    main()
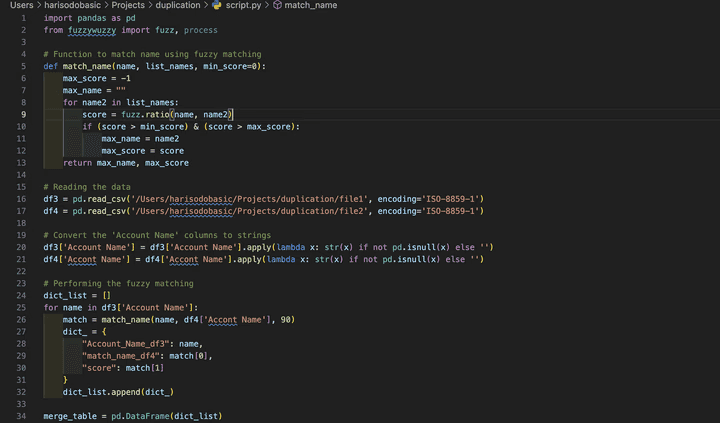
Ten opzichte van de versie uit 2023 is er een en ander veranderd. De typfout in de kolomnaam is weg (de kolom per bestand is een optie), er is geen vast bestandspad meer, fuzzywuzzy is vervangen door RapidFuzz, namen worden genormaliseerd, twijfelgevallen gaan naar review, en elke match krijgt het CRM-record-ID mee.
Waarom het oude script voor fuzzy matching traag was
Het script uit 2023 vergeleek elke nieuwe naam met elke CRM-naam in een pure Python-lus. Dat is 30.000 keer 10.000, oftewel 300 miljoen vergelijkingen, elk een aanroep van een Python-functie. Daarom duurde het minuten.
De nieuwe versie geeft de binnenste lus door aan process.extractOne van RapidFuzz, dat in C++ draait en kandidaten overslaat die de minimale score niet kunnen halen. In onze test met 30.000 synthetische bedrijfsnamen tegen 10.000 was het in 37 seconden klaar op een laptop, op één core.
Bij veel grotere lijsten verminder je het aantal vergelijkingen in plaats van ze te versnellen. Vergelijk alleen namen die een land, een beginletter of een domein delen (een techniek die blocking heet), of gebruik process.cdist van RapidFuzz met meerdere workers.
Checklist voor het veilig samenvoegen van duplicaten in je CRM
Matchen is het makkelijke deel. Het CRM bijwerken zonder goede data kwijt te raken vraagt discipline.
- Exporteer een volledige back-up van de betreffende objecten voordat je iets verandert, en beschouw samenvoegingen als onomkeerbaar.
- Voeg nooit automatisch samen. Bekijk elke rij in de reviewcategorie en doe steekproeven in de matchcategorie.
- Importeer matches als updates op basis van het CRM-record-ID; in HubSpot is de Record ID (of voor bedrijven de domeinnaam) de unieke identifier die bestaande records bijwerkt in plaats van nieuwe aan te maken.
- Zijn twee CRM-records duplicaten, houd dan het record waarmee andere systemen synchroniseren aan als primair record. Bij HubSpot en Salesforce is dat het record dat op dat moment synchroniseert, zoals we uitleggen in onze gids voor de integratie van HubSpot en Salesforce.
- Importeer parent-records vóór child-records, en houd een koppeltabel bij van oude naar nieuwe ID's.
- Draai de match na de import opnieuw om te bevestigen dat er niets nieuws is tussengeglipt.
In de CRM's van klanten blijven duplicaten zelden een cosmetisch probleem, want contacten en deals komen aan het verkeerde account te hangen, of aan geen enkel account, en elke roll-up neemt de fout over. Werk je met HubSpot en blijven de duplicaten terugkomen, dan vindt onze CRM Health Check de formulieren, imports en integraties die ze veroorzaken. De ene fix die we bouwen, kan een ontdubbeltool zoals deze zijn, die waarschijnlijke duplicaten markeert voor review op basis van regels die jij kiest.
Wanneer je een deduplicatietool gebruikt in plaats van een script
- Doorlopende preventie hoort in het CRM. Matching rules in Salesforce vinden waarschijnlijke duplicaten en duplicate rules blokkeren ze of waarschuwen de gebruiker; HubSpot ontdubbelt contacten automatisch op e-mail en bedrijven op domein. Zet deze eerst aan.
- Bulkimports en rommelige namen vragen om een script. Bij merknamen tegenover juridische namen, lijsten van leveranciers zonder domeinen en eenmalige migraties verdient dit script zichzelf terug.
- Ontdubbel niet met workflowtools. Automatiseringen in Zapier of Make hebben geen ingebouwde ontdubbeling en kunnen zelf duplicaten aanmaken.
- Koop een tool als het een vaste taak wordt. Ontdubbel je elke week over meerdere objecten, dan kan een gespecialiseerde tool beter zijn dan een script onderhouden. Onze gids over build vs buy helpt je kiezen.
Ik hoop dat dit je helpt. Het heeft mij talloze uren werk bespaard, en een investering in een tool om het probleem op te lossen. Is je duplicatenprobleem groter dan één import, begin dan met onze CRM Health Check.
FAQ over CRM-deduplicatie met Python
Wat is fuzzy matching?
Fuzzy matching vergelijkt strings op gelijkenis in plaats van op exacte overeenkomst, zodat "Hewlet Pakkard" toch kan matchen met "Hewlett Packard". Het geeft een score, meestal van 0 tot 100, en jij kiest de drempel die als match telt.
Welke drempel voor fuzzy matching gebruik ik voor bedrijfsnamen?
Begin bij 90 voor een match en stuur 80 tot 90 naar handmatige review. Hogere drempels missen echte matches; lagere leveren foute matches op. Test eerst op een steekproef van je eigen data.
Waarom RapidFuzz in plaats van fuzzywuzzy?
fuzzywuzzy is hernoemd tot thefuzz en de oorspronkelijke repository is in augustus 2024 gearchiveerd. RapidFuzz gebruikt dezelfde berekeningen voor gelijkenis, is veel sneller en heeft een MIT-licentie. Het is grotendeels een drop-in vervanging, maar vanaf versie 3.0 bewerkt het strings standaard niet meer vooraf.
Kan dit script duplicaten automatisch samenvoegen?
Nee, en dat is bewust. Het matcht en labelt elke rij als match, review of new. Daarna importeer je matches als updates op basis van het CRM-record-ID en voeg je echte duplicaten na een menselijke controle samen in het CRM, omdat samenvoegingen lastig of niet terug te draaien zijn.
Hoe werk ik bestaande CRM-records bij in plaats van nieuwe aan te maken?
Neem een unieke identifier op in het importbestand. In HubSpot is dat de Record ID, of voor bedrijven de domeinnaam; zonder identifier maken imports duplicaten aan in plaats van records bij te werken. Daarom geeft het script voor elke match het CRM-record-ID terug.