 Haris Odobasic
Um ein CRM zu aktualisieren, ohne Dubletten zu erzeugen, gleichen Sie jeden neuen Datensatz vor dem Import mit dem ab, was bereits im CRM steht, und importieren die Treffer dann als Updates über die Record-ID aus dem CRM. Wenn Firmennamen nicht exakt übereinstimmen, erledigt ein kurzes Python-Skript mit Fuzzy Matching (pandas plus RapidFuzz) das für Zehntausende Zeilen in unter einer Minute.
Python kann in Revenue Operations sehr nützlich sein. Ich setze es gern ein, wenn ich mit Daten arbeiten muss. So sieht auch GTM Engineering im Alltag aus. Es ist ein kleines, gezieltes Werkzeug, das manuelle Arbeit ersetzt und die Daten schützt, die jeder Bericht, jeder Forecast und jeder KI-Agent liest.
Warum der Abgleich von 30.000 Accounts mit einem CRM jede Tabellenkalkulation überfordert
Kürzlich mussten wir eine Liste mit 30.000 Accounts mit einem CRM abgleichen, das bereits 10.000 Accounts enthielt. Sie können sich denken, dass es jede Menge Dubletten gab.
Das Hauptproblem war, dass das CRM oft den Markennamen (The Lego Group) nutzte, während die neue Datei nur juristische Namen enthielt (Lego A/S). Ärgerlich.
Das bedeutet, 300 Millionen mögliche Paare zu vergleichen. Daran scheitern Tabellenprogramme wie Excel oder Google Sheets (bei mir jedenfalls).
Tipp: Bevor Sie Daten ins CRM importieren, sollte Ihr Datensatz in bestmöglichem Zustand sein. Sobald die Daten im CRM sind, werden Korrekturen viel zeitaufwendiger (und teurer). Ein schneller Selbsttest wie unser RevOps Data Assessment zeigt, wo Sie stehen.
Warum Python und KI für den Abgleich von CRM-Daten
Ich ahne es. Python klingt einschüchternd? Das dachte ich auch. Mein Code ist alles andere als perfekt. Heute ist es aber leichter zu lernen als je zuvor, und KI-Assistenten wie ChatGPT verändern alles. In wenigen Monaten lernen Sie genug, um es für geschäftliche Anwendungsfälle wie Fuzzy Matching einzusetzen. Unser KI-Playbook für Sales und RevOps zeigt, wo sich KI noch auszahlt.
Wie Fuzzy Matching doppelte Firmennamen findet
Sie brauchen die beiden Dateien, die Sie abgleichen möchten. In unserem Fall waren das diese beiden.
- Datei 1 ist der Export aus dem CRM, einschließlich der Record-ID.
- Datei 2 enthält die neuen Daten des Datenanbieters.
Tipp: Stellen Sie sicher, dass es innerhalb jeder Datei keine Dubletten gibt. Das Skript warnt Sie, wenn es welche findet.
Abgleichvariable. Jede Datei braucht eine Spalte, über die abgeglichen wird. In unserem Beispiel haben beide eine Spalte namens „Account Name“. Wenn sich die Spaltennamen zwischen den Dateien unterscheiden, legen Sie sie beim Ausführen des Skripts jeweils separat fest.
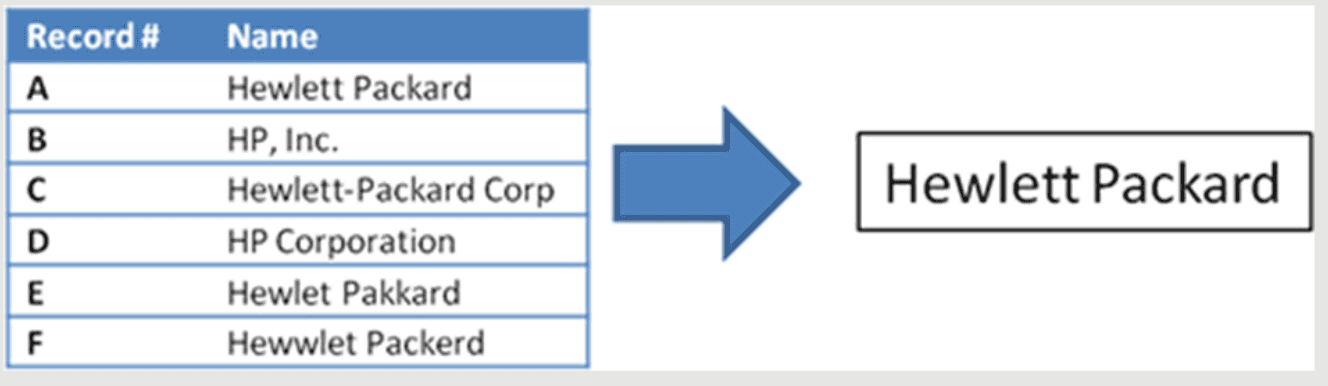
Fuzzy Matching. Fuzzy Matching ist eine Methode zum näherungsweisen Abgleich von Zeichenketten. Einfach gesagt ordnet es ähnliche Wörter einander zu, wie im Bild unten.
Hier finden Sie eine ausführliche Erklärung des Konzepts.
Für unsere Zwecke müssen Sie nur wissen, dass ein Fuzzy Match einen Ähnlichkeitsschwellenwert braucht. Der Prozentsatz sagt dem Skript, wie ähnlich sich zwei Namen sein müssen, um als Treffer zu gelten.
- Zu hoch, zum Beispiel 97%, und Sie verpassen echte Treffer.
- Zu niedrig, zum Beispiel 84%, und Sie bekommen mehr falsche Treffer.
Bewährt haben sich 90 bis 95%. Das Skript nutzt 90 für einen Treffer und behandelt 80 bis 90 als „review“, sodass sich ein Mensch die Grenzfälle ansieht, statt dass das Skript rät.
Sie können unter 90 gehen, machen Sie dann aber einige Testläufe und prüfen Sie die Ergebnisse manuell auf seltsame Treffer. Es hängt ganz von Ihren Quelldaten ab.
Zuerst normalisieren. Vor dem Vergleich schreibt das Skript Namen klein, entfernt Satzzeichen und streicht Rechtsformen und Füllwörter (Ltd, GmbH, B.V., A/S, Group, The). Dieser Schritt leistet die meiste Arbeit. Seit Version 3.0 verarbeitet RapidFuzz Zeichenketten standardmäßig nicht mehr vor, deshalb erledigt das Skript das explizit.
So sieht das für die Namen im Bild aus, im Skript abgeglichen mit einem CRM-Datensatz namens „Hewlett Packard“.
| Neuer Name | Score | Status |
|---|---|---|
| Hewlett-Packard Corp | 100 | match |
| Hewlet Pakkard | 89,7 | review |
| Hewwlet Packerd | 86,7 | review |
| HP, Inc. | kein Treffer | new |
| HP Corporation | kein Treffer | new |
Fuzzy Matching erkennt Tippfehler und Rechtsformzusätze. Es weiß nicht, dass HP und Hewlett Packard dasselbe Unternehmen sind. Dafür gibt es Domains.
Über welche Felder Sie abgleichen, um Dubletten zu vermeiden
| Abgleich über | Stärke | Hinweise |
|---|---|---|
| Website-Domain | Am stärksten | HubSpot selbst dedupliziert Unternehmen über den Domainnamen und Kontakte über die E-Mail-Adresse |
| Handelsregister- oder USt-IdNr. | Stark | Zuverlässig, wenn Ihr Datenanbieter sie liefert |
| Normalisierter Name plus Land | Gut | Was dieses Skript macht; ergänzen Sie das Land, um gleichnamige Unternehmen zu trennen |
| Nur Name | Am schwächsten | Nutzen Sie die Prüfkategorie und kontrollieren Sie von Hand |
Vollständiges Python-Skript für Fuzzy Matching von CRM-Accounts
Beim Ausführen müssen Sie nur wenige Optionen festlegen.
- die beiden Dateipfade
- die Abgleichspalte in jeder Datei (standardmäßig „Account Name“)
- die Spalte mit der CRM-Record-ID (standardmäßig „Record ID“)
- den Schwellenwert für Treffer und die Untergrenze für die Prüfung (standardmäßig 90 und 80)
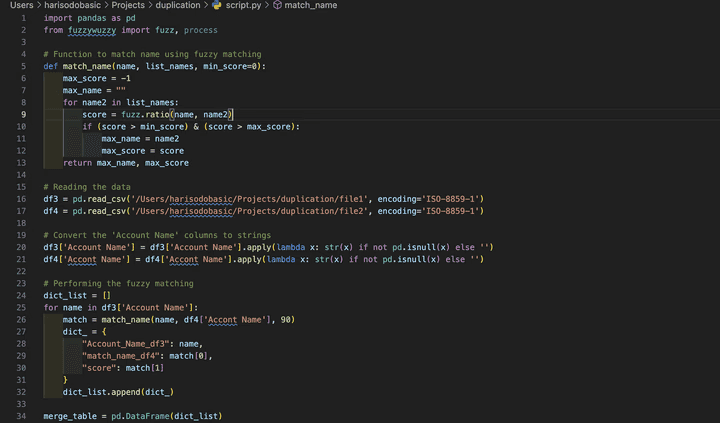
Installieren Sie die beiden Bibliotheken einmalig mit pip install pandas rapidfuzz, und führen Sie dann das folgende Skript aus.
python match_accounts.py crm_accounts.csv new_accounts.csv --crm-column "Account Name" --new-column "Account Name"
Das Skript schreibt matches.csv mit einer Zeile pro neuem Account. Darin stehen der beste Treffer im CRM, dessen Record-ID, der Score und ein Status (match, review oder new).
"""Match a new account list against your CRM before import, so you update instead of duplicating.

Usage:
    python match_accounts.py crm_accounts.csv new_accounts.csv \
        --crm-column "Account Name" --new-column "Account Name" \
        --crm-id-column "Record ID" --threshold 90 --review-floor 80

Output: matches.csv with one row per new account and a status column:
    match  = score >= threshold: update the existing CRM record (use its record ID)
    review = score between review-floor and threshold: a human decides
    new    = no good match: import as a new record
"""
import argparse
import re

import pandas as pd
from rapidfuzz import fuzz, process, utils

DROP_TOKENS = {  # legal forms and filler words that make the same company look different
    # extend this set for the countries you sell into
    "the", "inc", "ltd", "llc", "plc", "corp", "corporation", "co", "company",
    "limited", "group", "holding", "holdings", "gmbh", "ag", "bv", "nv",
    "sa", "sas", "srl", "spa", "as", "aps", "ab", "oy", "kg",
}


def normalise(name):
    """Lowercase, strip punctuation and legal forms: 'Lego A/S' and 'The LEGO Group' both become 'lego'."""
    if pd.isna(name):
        return ""
    tokens = utils.default_process(str(name)).split()
    merged, letters = [], ""
    for token in tokens:  # glue initials back together: 'b v' -> 'bv', 'a s' -> 'as'
        if len(token) == 1:
            letters += token
            continue
        if letters:
            merged.append(letters)
            letters = ""
        merged.append(token)
    if letters:
        merged.append(letters)
    kept = [t for t in merged if t not in DROP_TOKENS]
    return " ".join(kept) if kept else " ".join(merged)


def main():
    parser = argparse.ArgumentParser(description=__doc__, formatter_class=argparse.RawDescriptionHelpFormatter)
    parser.add_argument("crm_file", help="CSV export from your CRM (must include the record ID)")
    parser.add_argument("new_file", help="CSV with the new accounts you want to import")
    parser.add_argument("--crm-column", default="Account Name")
    parser.add_argument("--new-column", default="Account Name")
    parser.add_argument("--crm-id-column", default="Record ID")
    parser.add_argument("--threshold", type=float, default=90)
    parser.add_argument("--review-floor", type=float, default=80)
    parser.add_argument("--encoding", default="utf-8-sig", help="try ISO-8859-1 if the export has odd characters")
    parser.add_argument("--out", default="matches.csv")
    args = parser.parse_args()

    crm = pd.read_csv(args.crm_file, encoding=args.encoding, dtype=str)
    new = pd.read_csv(args.new_file, encoding=args.encoding, dtype=str)
    for df, col, label in ((crm, args.crm_column, "CRM file"), (new, args.new_column, "new file")):
        if col not in df.columns:
            raise SystemExit(f"Column '{col}' not found in the {label}. Columns: {list(df.columns)}")

    crm["_key"] = crm[args.crm_column].map(normalise)
    new["_key"] = new[args.new_column].map(normalise)

    # Duplicates inside each file come first: fix them before matching across files.
    for df, label in ((crm, "CRM file"), (new, "new file")):
        dupes = df[df["_key"].ne("") & df.duplicated("_key", keep=False)]
        if len(dupes):
            print(f"Warning: {len(dupes)} rows in the {label} share a normalised name with another row.")

    choices = crm["_key"].tolist()
    rows = []
    for _, record in new.iterrows():
        best = None
        if record["_key"]:
            # extractOne runs in C++ and stops early below score_cutoff
            best = process.extractOne(record["_key"], choices, scorer=fuzz.token_sort_ratio,
                                      score_cutoff=args.review_floor)
        if best:
            _, score, position = best
            status = "match" if score >= args.threshold else "review"
            crm_name = crm.at[position, args.crm_column]
            crm_id = crm.at[position, args.crm_id_column] if args.crm_id_column in crm.columns else ""
        else:
            score, status, crm_name, crm_id = 0, "new", "", ""
        rows.append({
            "new_name": record[args.new_column],
            "crm_match": crm_name,
            "crm_record_id": crm_id,
            "score": round(score, 1),
            "status": status,
        })

    result = pd.DataFrame(rows)
    result.to_csv(args.out, index=False)
    print(result["status"].value_counts().to_string())
    print(f"Saved {len(result)} rows to {args.out}")


if __name__ == "__main__":
    main()
Gegenüber der Version von 2023 hat sich einiges geändert. Der Tippfehler im Spaltennamen ist weg (die Spalte jeder Datei ist eine Option), es gibt keinen fest codierten Dateipfad mehr, fuzzywuzzy ist durch RapidFuzz ersetzt, Namen werden normalisiert, Grenzfälle gehen in die Prüfung, und jeder Treffer enthält die CRM-Record-ID.
Warum das alte Fuzzy-Matching-Skript langsam war
Das Skript von 2023 verglich jeden neuen Namen mit jedem CRM-Namen in einer reinen Python-Schleife. Das sind 30.000 mal 10.000, also 300 Millionen Vergleiche, jeder ein Python-Funktionsaufruf. Deshalb dauerte es Minuten.
Die neue Version übergibt die innere Schleife an process.extractOne von RapidFuzz, das in C++ läuft und Kandidaten überspringt, die den Mindestscore nicht erreichen können. In unserem Test mit 30.000 synthetischen Firmennamen gegen 10.000 war es auf einem Laptop nach 37 Sekunden fertig, auf einem einzigen Kern.
Bei viel größeren Listen reduzieren Sie die Zahl der Vergleiche, statt sie zu beschleunigen. Vergleichen Sie nur Namen, die ein Land, einen Anfangsbuchstaben oder eine Domain teilen (eine Technik namens Blocking), oder nutzen Sie process.cdist von RapidFuzz mit mehreren Workern.
Checkliste für das sichere Zusammenführen von Dubletten im CRM
Der Abgleich ist der einfache Teil. Das CRM zu aktualisieren, ohne gute Daten zu verlieren, erfordert Disziplin.
- Exportieren Sie ein vollständiges Backup der betroffenen Objekte, bevor Sie etwas ändern, und behandeln Sie Zusammenführungen als unumkehrbar.
- Führen Sie niemals automatisch zusammen. Prüfen Sie jede Zeile in der Prüfkategorie und machen Sie Stichproben in der Trefferkategorie.
- Importieren Sie Treffer als Updates über die CRM-Record-ID; in HubSpot ist die Record ID (bei Unternehmen auch der Domainname) die eindeutige Kennung, mit der bestehende Datensätze aktualisiert statt neue angelegt werden.
- Wenn zwei CRM-Datensätze Dubletten sind, behalten Sie den als primären Datensatz, mit dem andere Systeme synchronisieren. Bei HubSpot und Salesforce ist das der aktuell synchronisierte Datensatz, wie wir in unserem Leitfaden zur Integration von HubSpot und Salesforce erklären.
- Importieren Sie übergeordnete Datensätze vor untergeordneten und führen Sie eine Zuordnung von alten zu neuen IDs.
- Führen Sie den Abgleich nach dem Import erneut aus, um sicherzugehen, dass nichts Neues durchgerutscht ist.
In den CRMs unserer Kunden bleiben Dubletten selten ein kosmetisches Problem, denn Kontakte und Deals hängen am falschen Account oder an gar keinem, und jede Roll-up-Auswertung erbt den Fehler. Wenn Sie HubSpot nutzen und die Dubletten immer wiederkommen, findet unser CRM Health Check die Formulare, Importe und Integrationen, die sie verursachen. Die eine Lösung, die wir bauen, kann ein Deduplizierungstool wie dieses sein, das wahrscheinliche Dubletten nach von Ihnen gewählten Regeln zur Prüfung markiert.
Wann ein Deduplizierungs-Tool statt eines Skripts sinnvoll ist
- Laufende Vorbeugung gehört ins CRM. Matching Rules in Salesforce finden wahrscheinliche Dubletten, Duplicate Rules blockieren sie oder warnen den Nutzer; HubSpot dedupliziert Kontakte automatisch über die E-Mail und Unternehmen über die Domain. Aktivieren Sie das zuerst.
- Massenimporte und unsaubere Namen sind ein Fall für ein Skript. Bei Markennamen gegen juristische Namen, Anbieterlisten ohne Domains und einmaligen Migrationen macht sich dieses Skript bezahlt.
- Deduplizieren Sie nicht mit Workflow-Tools. Automatisierungen in Zapier oder Make haben keine eingebaute Deduplizierung und können selbst Dubletten erzeugen.
- Kaufen Sie, wenn es zur Daueraufgabe wird. Wenn Sie jede Woche über mehrere Objekte hinweg deduplizieren, kann ein spezialisiertes Tool besser sein, als ein Skript zu pflegen. Unser Build-vs-Buy-Leitfaden hilft bei der Entscheidung.
Ich hoffe, das war hilfreich. Mir hat es unzählige Arbeitsstunden und die Investition in ein Tool erspart. Wenn Ihr Dublettenproblem größer ist als ein einzelner Import, beginnen Sie mit unserem CRM Health Check.
FAQ zur CRM-Deduplizierung mit Python
Was ist Fuzzy Matching?
Fuzzy Matching vergleicht Zeichenketten nach Ähnlichkeit statt nach exakter Gleichheit, sodass „Hewlet Pakkard“ trotzdem „Hewlett Packard“ zugeordnet werden kann. Es liefert einen Score, meist von 0 bis 100, und Sie wählen den Schwellenwert, der als Treffer zählt.
Welchen Schwellenwert für Fuzzy Matching sollte ich bei Firmennamen verwenden?
Beginnen Sie mit 90 für einen Treffer und schicken Sie 80 bis 90 in die manuelle Prüfung. Höhere Schwellenwerte verpassen echte Treffer, niedrigere erzeugen falsche. Testen Sie zuerst mit einer Stichprobe Ihrer eigenen Daten.
Warum RapidFuzz statt fuzzywuzzy?
fuzzywuzzy wurde in thefuzz umbenannt, und das ursprüngliche Repository wurde im August 2024 archiviert. RapidFuzz nutzt dieselben Ähnlichkeitsberechnungen, ist viel schneller und steht unter MIT-Lizenz. Es ist weitgehend ein Drop-in-Ersatz, verarbeitet Zeichenketten ab Version 3.0 aber standardmäßig nicht mehr vor.
Kann dieses Skript Dubletten automatisch zusammenführen?
Nein, und zwar bewusst. Es gleicht ab und kennzeichnet jede Zeile als match, review oder new. Danach importieren Sie Treffer als Updates über die CRM-Record-ID und führen echte Dubletten nach einer menschlichen Prüfung im CRM zusammen, denn Zusammenführungen lassen sich nur schwer oder gar nicht rückgängig machen.
Wie aktualisiere ich bestehende CRM-Datensätze, statt neue anzulegen?
Nehmen Sie eine eindeutige Kennung in die Importdatei auf. In HubSpot ist das die Record ID, bei Unternehmen auch der Domainname; ohne Kennung erzeugen Importe Dubletten, statt Datensätze zu aktualisieren. Deshalb gibt das Skript für jeden Treffer die CRM-Record-ID zurück.