 Haris Odobasic
CRM-Datenbankdesign beschreibt, wie Sie Objekte, Felder und Beziehungen in Ihrem CRM strukturieren, damit es Revenue-Fragen ohne manuelle Bereinigung beantworten kann. Gutes Design speichert jede Information an genau einer Stelle, bildet ab, wie Ihre Kunden tatsächlich kaufen, und stoppt Dubletten und überflüssige Felder dort, wo sie entstehen.
In zwei Tagen steht eine Board-Sitzung an, und Sie sollen die Wirkung von Marketingkampagnen auf Verlängerungen analysieren. Wie schnell können Sie diese Erkenntnis liefern? Wenn Ihre Antwort nicht "sofort" lautet, ist Ihr Datenfluss vermutlich verstopft, und die Ursache liegt meist in der Struktur darunter, nicht im Dashboard darüber.
Warum CRM-Datenbankdesign ein Revenue-Problem ist
Begriffe wie "360-Grad-Kundensicht", "datengetriebene Entscheidungen", "KI-Integration" und "Revenue Analytics" sind das Ziel aller, die Sales-, Marketing- oder Customer-Success-Operations verantworten. Dutzende Tools versprechen genau das. Sie alle stoßen auf dasselbe Hindernis, nämlich ein schlecht strukturiertes Datensystem.
Das ausgefeilteste Tool ist nutzlos, wenn die Struktur darunter nicht trägt. Das ist etwas anderes als Datenqualität, die sich auf die in Ihr System eingegebenen Daten bezieht. Die Datenstruktur umfasst die Designentscheidungen, die festlegen, welche Fragen Ihre Datenbank überhaupt beantworten kann.
Wenn die Geschäftsführung fragt, wo Opportunities verloren gehen, welche Inhalte Neugeschäft beeinflussen oder was Advocacy-Programme für den Ausbau bringen, sollten die Antworten sofort verfügbar sein. Ohne solides Fundament wird jede dieser Fragen zu einem Projekt, in dem Exporte von Hand zusammengeführt werden.
Das Muster in unserer Kundenarbeit 2026 ist eindeutig. Reportingprobleme sind meist nachgelagerte Symptome von unklarer Datensatzidentität, schwacher Datenverantwortung und Feldern, die schneller hinzugefügt als standardisiert wurden. Die Sichten auf Pipeline, ARR, Attribution und Win Rate widersprechen sich dann, und niemand vertraut mehr einer davon.
Was CRM-Datenbankdesign bedeutet
CRM-Datenbankdesign ist die Disziplin, die Struktur für Ihre Kundeninformationen zu entwerfen, umzusetzen und zu pflegen. Ihr Ziel ist ein logisches Modell des CRM, das festhält, welche Datensätze existieren, wie sie miteinander zusammenhängen und wie sie abgerufen werden.
Die gute Nachricht ist, dass Salesforce und HubSpot einen Großteil der schweren Arbeit bereits erledigt haben. Beide sind relationale Datenbanken, also Tabellen mit Datensätzen, die über Schlüssel verknüpft sind. Sie müssen selten ein Schema von Grund auf entwerfen. Ihre Aufgabe ist es, die richtigen Objekte zu wählen, die Beziehungen zu respektieren, die die Plattform vorgibt, und dem Wildwuchs an Custom Fields zu widerstehen.
Die Kernobjekte und ihre Beziehungen
| Objekt | Was es darstellt | Wichtigste Beziehungen | Häufiger Fehler |
|---|---|---|---|
| Account (Unternehmen) | Die juristische Einheit oder Einkaufseinheit, an die Sie verkaufen | Über- und untergeordnete Accounts, Kontakte, Opportunities | Markenname und juristischer Name als zwei Accounts gespeichert |
| Kontakt | Eine Person bei einem Account | Gehört zu einem Account; hat Rollen auf Opportunities | Kontakte ohne Account |
| Lead | Ein Interessent in einer frühen Phase, der noch qualifiziert wird | Wird in Salesforce in Account, Kontakt und Opportunity umgewandelt; in HubSpot ein eigenes Objekt, das mit Kontakten und Unternehmen verknüpft ist | Leads, die ewig offen bleiben, statt umgewandelt oder geschlossen zu werden |
| Opportunity (Deal) | Ein möglicher Verkauf mit Betrag, Phase und Abschlussdatum | Account, Kontakte mit Rollen, Line Items | Die Umsatzart in eine einzige Auswahlliste auf dem Deal gepresst |
| Line Item und Produkt | Was zu welchem Preis und welcher Laufzeit verkauft wird | Opportunity und Produktkatalog | Line Items ohne Verknüpfung zur Produktbibliothek importiert |
| Angebot, Vertrag, Abonnement | Die unterschriebenen kommerziellen Bedingungen | Opportunity, Account, Abrechnungssystem | Verlängerungslogik im CRM nachgebaut, statt sie aus der Abrechnung zu lesen |
| Aktivität | E-Mails, Anrufe, Meetings und Aufgaben | Kontakt, Account, Opportunity | Mehrere Tools protokollieren dieselbe E-Mail |
| Ticket (Case) | Eine Serviceanfrage | Kontakt und Account | Tickets ohne Verknüpfung zum zahlenden Account |
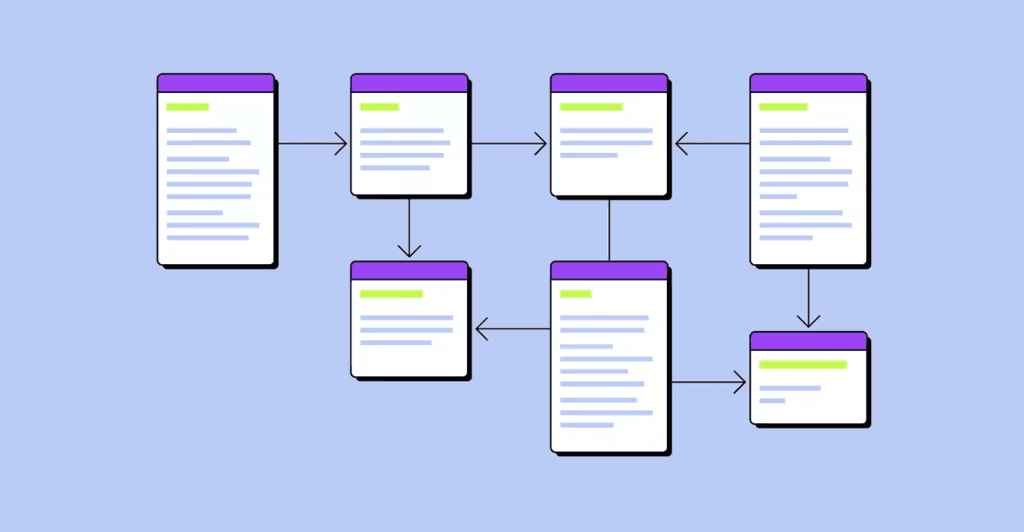
Die folgende Skizze zeigt die Beziehungen in einem typischen B2B-Setup.
Übergeordneter Account
  └── Account (Unternehmen oder Standort) ── Kontakte (mit Rollen)
        └── Opportunity ── Line Items ── Produkte
              └── Angebot → Vertrag oder Abonnement → Verlängerungs-Opportunity

Lead ── qualifiziert ──→ Account + Kontakt + Opportunity
Sechs Designprinzipien
- Eine Information, eine Stelle. Speichern Sie dieselbe Information nicht doppelt. Das verschwendet Platz, verlangsamt das System und garantiert Inkonsistenzen, denn liegt eine Information in zwei Tabellen, widersprechen sie sich früher oder später. Modellieren Sie eine Beziehung, statt die Daten zu kopieren.
- Bilden Sie ab, wie Ihre Kunden kaufen. Werden Verträge mit einer Gruppe geschlossen, der Umsatz aber an den Standorten erzielt, modellieren Sie Einkaufseinheit und Umsatzeinheit getrennt und messen Sie Churn dort, wo er entsteht. Platzieren Sie Kontakte dort, wo die Arbeit stattfindet, und importieren Sie keine Standorte oder Tochtergesellschaften, die nie Umsatz bringen werden.
- Legen Sie Umsatzdetails auf Line Items ab. Ein einzelnes Feld für den Deal-Typ kann kein Bundle, keine wiederkehrenden und einmaligen Bestandteile und keinen Mehrjahresvertrag beschreiben. Mit Kunden nutzen wir Line Items und Produktfamilien als Quelle der Umsatzklassifizierung und aggregieren sie zur besseren Nutzbarkeit auf die Opportunity. Unser Beitrag zu ARR-Reporting mit Custom Snapshots zeigt, was schiefgeht, wenn diese Ebene fehlt.
- Struktur schlägt Freitext. Nutzen Sie Auswahllisten statt offener Textfelder, Validierungsregeln für E-Mail-Adressen und Telefonnummern sowie Pflichtfelder, die an die Exit-Kriterien der Phasen gekoppelt sind. Übertreiben Sie es aber nicht. Bei zu vielen Pflichtfeldern tippen Reps irgendetwas ein, nur um weiterzukommen.
- Halten Sie das CRM beim kommerziellen Prozess. Das CRM verkauft, das Produkt liefert und Finance zählt. Nutzung, Fulfillment und Rechnungen gehören in die Systeme, die sie sehen, und sollten als schreibgeschützte Ergebnisse im CRM ankommen, nicht als nachgebaute Prozesse. Unser Leitfaden zu kommerziellem vs. finanziellem RevOps zeigt, wo diese Grenze verläuft.
- Gestalten Sie für die Menschen, die die Daten eingeben. Das Modell muss zur täglichen Arbeitsweise von Vertrieb, Marketing und Customer Success passen. Fordern Sie nur die minimal nötige Eingabe und erfassen Sie den Rest automatisch; Akzeptanz ist ein Designproblem, bevor sie ein Schulungsproblem ist.
Regeln für die Feld-Governance
An den Feldern verfallen die meisten CRMs, und einige Regeln halten sie unter Kontrolle.
- Jedes Feld hat eine verantwortliche Person, eine verständliche Beschreibung und einen benannten Bericht oder eine Automatisierung, die es nutzt.
- Bevor jemand ein Feld oder eine Tabelle hinzufügt, prüfen Sie den Nutzen und ob ein bestehendes Objekt oder Feld die Aufgabe übernehmen kann.
- Verwenden Sie eine einheitliche Namenskonvention und halten Sie Optionswerte in allen integrierten Systemen identisch.
- Bevorzugen Sie Auswahllisten mit dokumentierten Werten; Freitext nur dort, wo Menschen wirklich schreiben müssen.
- Machen Sie Felder in der Phase zur Pflicht, in der sie relevant sind, nicht beim Anlegen des Datensatzes.
- Prüfen Sie jedes Quartal die Füllrate und die letzte Nutzung jedes Felds und welche Berichte und Automatisierungen es lesen. Blenden Sie ein Feld zuerst in den Layouts aus, bewahren Sie seine Historie und löschen Sie es erst dann.
Dubletten an der Quelle stoppen
Dubletten zu ignorieren ist sehr verbreitet, und meist bedeutet es, dass die Beziehungen zwischen den Tabellen nie durchdacht wurden. In Kunden-CRMs sehen wir das Ergebnis ständig. Kontakte und Deals sind mit dem falschen Account verknüpft oder mit gar keinem, sodass jede Aggregation falsch ist.
Dubletten kommen durch fünf Türen herein, nämlich über manuelle Eingabe, Integrationen und Synchronisationen, Webformulare, Anreicherung durch Drittanbieter und automatische Erfassung. Schließen Sie jede davon.
- Nutzen Sie die Regeln der Plattform. In Salesforce erkennen Matching Rules mögliche Dubletten, und Duplicate Rules entscheiden, ob der Datensatz blockiert oder mit einer Warnung zugelassen wird. Salesforce liefert Standard-Matching-Rules für Business Accounts, Contacts, Leads und Person Accounts. HubSpot erlaubt nicht, dass zwei Datensätze dieselbe E-Mail-Adresse teilen, was wichtig wird, sobald Sie mit einem CRM synchronisieren, das dies zulässt.
- Standardisieren Sie Namen. Vereinbaren Sie Konventionen für Rechtsformen und Markennamen ("ACME Corp" vs. "Acme Corporation"), damit Datensätze desselben Unternehmens auch tatsächlich übereinstimmen.
- Abgleichen vor dem Import. Wenn eine Liste neuer Accounts eintrifft, vergleichen Sie sie mit dem Bestand im CRM, bevor Sie etwas laden. Unsere Python-Anleitung zum Abgleich von Accounts vor dem Import zeigt einen Weg dafür.
- Legen Sie fest, welche Quelle gewinnt. Wenn Anreicherungsdaten bestehenden Werten widersprechen, halten Sie fest, welches System für welches Feld maßgeblich ist.
- Bereinigen Sie in festen Abständen. Regeln erfassen nie alles, also führen Sie regelmäßig eine Deduplizierung durch und führen Sie zusammen, was durchgerutscht ist.
Wenn Ihr CRM auf HubSpot läuft und die Dubletten immer wieder auftauchen, prüft unser CRM Health Check das Setup dahinter. Dazu gehören Dublettenregeln, Pflichtfelder sowie die Formulare, Importe und Integrationen, die Datensätze anlegen. Der Check priorisiert die Lücken und baut eine funktionierende Lösung für die größte.
Hinweise zu den Datenmodellen von HubSpot und Salesforce
- Salesforce trennt Leads von Accounts, Contacts und Opportunities. Leads sind Interessenten in einer frühen Phase, die qualifiziert werden müssen; wenn Sie einen Lead umwandeln, erstellt Salesforce aus seinen Daten einen Business Account, einen Contact und eine Opportunity.
- HubSpot dreht sich um Kontakte, Unternehmen, Deals und Tickets, mit bidirektionalen Verknüpfungen zwischen Datensätzen. Ein eigenes Leads-Objekt gibt es mit Sales Hub Professional oder Enterprise, Association Labels erfordern Professional oder höher, und Custom Objects erfordern ein Enterprise-Abonnement.
Braucht Ihr Modell zusätzliche Objekte (Standorte, Abonnements, Partner), ist das bei HubSpot eine Enterprise-Voraussetzung und bei Salesforce eine Verpflichtung zu klarer Verantwortung. Unser Vergleich von HubSpot und Salesforce zeigt, wann welche Plattform passt.
Design für KI
Gut strukturierte Daten sind Voraussetzung für jedes KI-Projekt. In unserem Bericht RevOps in 2026, einer Umfrage unter 123 RevOps-Praktikern, haben 73% der Teams ein KI-Mandat und 38% die Daten, um es zu unterstützen.
Der Grund ist einfach. Daten sind kein Kontext. Ein Agent lernt aus Ihren Datensätzen, wie gearbeitet wird, nicht wie gearbeitet werden sollte. Übersprungene Phasen, leere Felder und Dubletten werden zu seinen Gewohnheiten. Bauen Sie die folgenden Elemente in das Modell ein, bevor Sie Agents aktivieren.
- stabile Datensatz-IDs und externe IDs für jedes integrierte System
- Felder für Quelle und Zeitstempel, etwa Lead-Quelle, Erstellungsdatum und Eintrittsdatum je Phase
- schriftliche Definitionen für jede Phase und jeden Status, abgelegt dort, wo Menschen und Agents sie lesen können
- ein Datum "zuletzt verifiziert" auf angereicherten Feldern
- Felder für Einwilligung und Rechtsgrundlage bei personenbezogenen Daten
- eine Kennzeichnung für Datensätze und Felder, die bekanntermaßen unzuverlässig sind, damit weder Berichte noch Agents sie als Wahrheit behandeln
Eine Checkliste für das Datenfundament von Startups
Startups haben selten am ersten Tag ein Datenproblem; sie bauen es sich in den ersten zwei Jahren auf. Stellen Sie sich Ihre Operations als Schweizer Uhr vor, in der die Daten die Zahnräder sind. Sitzt eines falsch, ist jede Anzeige falsch. Sechs Gewohnheiten halten das Fundament stabil.
- Analysieren, nicht lähmen. Bevor Sie dem Schema ein Feld oder eine Tabelle hinzufügen, egal ob die Anfrage von innerhalb oder außerhalb des Teams kommt, prüfen Sie den Nutzen und ob es einfacher geht. Berücksichtigen Sie die Beziehungen zwischen Tabellen und die beste Nutzung bestehender Objekte.
- Entwerfen Sie einen Bauplan Ihrer Datenarchitektur. Gestalten Sie gemeinsam mit Ihren Data Engineers und Entwicklern, damit CRM-, Abrechnungs- und Produktdaten verbunden sind, statt sich gegenseitig zu kopieren. Zielen Sie auf ein Fundament, das hält, nicht auf ein Provisorium.
- Vermeiden Sie schnelle Notlösungen. Ein temporäres Feld oder ein Workaround wird schneller dauerhaft, als irgendjemand plant.
- Pflegen Sie Datenhygiene. Standardisieren, validieren und deduplizieren Sie nach einem festen Zeitplan, nicht einmalig.
- Dokumentieren Sie Prozesse. Behandeln Sie Dokumentation als Teil der Planung und aktualisieren Sie sie bei Änderungen; so können neue Mitarbeitende oder ein KI-Agent Ihrem Prozess folgen.
- Verbessern Sie kontinuierlich. Neue Produkte, Segmente und Märkte erfordern Änderungen am Modell, also prüfen Sie regelmäßig. Unser kostenloses RevOps Data Assessment ist ein schneller Einstieg.
Häufige Fallstricke
- Datenbankdesign vernachlässigen. Viele CRMs wurden ohne jedes Design eingeführt, was zum Problem wird, sobald die Geschäftsführung datengetriebene Entscheidungen verlangt.
- Dubletten und ignorierte Beziehungen. Dubletten zeigen meist, dass die Beziehungen zwischen Tabellen nie bedacht wurden.
- Die falsche Beziehung. Ein Kontakt am falschen Account oder ein Lookup mit nur einem übergeordneten Datensatz, der Kunden mit mehreren Gesellschaften in eine einzige Form zwingt, zerstört Aggregationen und die Verlängerungshistorie.
- Wildwuchs bei Feldern. Veraltete, überlappende und ungenutzte Felder überladen Layouts und verwirren Nutzer.
- Ein aufgeblähtes CRM. Produkt- und operative Prozesse, die im CRM nachgebaut werden, mit künstlichen Pipelines und Objekten, die Backend-Tabellen spiegeln.
Eine Checkliste für das Audit Ihres eigenen CRM
- Können Sie "welche Kampagnen haben Verlängerungen beeinflusst" ohne Exporte aus dem CRM beantworten?
- Existiert jedes Unternehmen genau einmal, mit einer verantwortlichen Person, und ohne Zwillinge aus Markenname und juristischem Namen?
- Bilden über- und untergeordnete Accounts ab, wie Kunden kaufen und unterschreiben?
- Gehört jeder Kontakt zu einem Account?
- Wird Umsatz auf Line Items oder Produkten klassifiziert statt über eine einzige Auswahlliste auf dem Deal?
- Hat jedes Feld eine verantwortliche Person, eine Beschreibung und einen Bericht oder eine Automatisierung, die es nutzt?
- Sind Pflichtfelder an die Exit-Kriterien der Phasen gekoppelt?
- Sind Matching- und Dublettenregeln für Accounts, Kontakte und Leads aktiv?
- Hat jede Information (Vertragsbedingungen, Nutzung, Rechnungen, ARR, Zuständigkeit) ein benanntes führendes System?
- Sind unzuverlässige Felder gekennzeichnet, damit Berichte und KI-Agents sie nicht als Wahrheit behandeln?
Wenn Ihre Antworten auf ein Redesign oder eine Migration hindeuten, beginnt unsere Arbeit an CRM-Implementierungen genau auf dieser Ebene, also bei Datenmodell und Objektdesign, Migration mit Deduplizierung, Feldbereinigung und Regeln für Zuständigkeiten. Vorausdenken ist der Weg zu nachhaltigem Wachstum; es vermeidet später teure Fehler.
FAQ zum CRM-Datenbankdesign
Was ist CRM-Datenbankdesign?
CRM-Datenbankdesign ist die Struktur aus Objekten, Feldern und Beziehungen in Ihrem CRM, zusammen mit den Regeln, die es sauber halten. Es entscheidet, welche Fragen das CRM beantworten kann, und kommt deshalb vor Dashboards, Automatisierung und KI.
Welche Objekte sollte ein B2B-CRM haben?
Die meisten B2B-CRMs brauchen Accounts, Kontakte, Opportunities und Line Items, die mit einem Produktkatalog verknüpft sind. Die meisten brauchen außerdem Leads, Angebote oder Verträge, Aktivitäten und Tickets. Fügen Sie Custom Objects nur hinzu, wenn eine reale Entität, etwa ein Standort oder ein Abonnement, nicht in die Standardobjekte passt.
Wie verhindert man doppelte Datensätze in einem CRM?
Verhindern Sie Dubletten an den Eingangspunkten. Nutzen Sie Matching- und Dublettenregeln, validieren Sie Formulare, steuern Sie, welche Integrationen Datensätze anlegen dürfen, und gleichen Sie neue Listen vor dem Import mit bestehenden Datensätzen ab. Führen Sie dann eine regelmäßige Bereinigung für das durch, was durchrutscht, denn keine Regel erfasst alles.
Was ist der Unterschied zwischen Datenqualität und Datenstruktur?
Datenqualität betrifft die Richtigkeit, Vollständigkeit und Aktualität der Werte, die Menschen und Systeme eingeben. Datenstruktur ist das Design, das festlegt, was gespeichert werden kann und wie Datensätze zusammenhängen. Gute Qualität kann eine schlechte Struktur nicht retten.
Nutzen HubSpot und Salesforce dasselbe Datenmodell?
Nein, obwohl beide relational sind. Salesforce trennt Leads von Accounts und Contacts und wandelt sie bei der Qualifizierung um. HubSpot dreht sich um Kontakte, Unternehmen und Deals, mit einem Leads-Objekt in Sales Hub Professional und Enterprise und Custom Objects in Enterprise.
Wie viele Custom Fields sind zu viele?
Es gibt keine feste Zahl. Ein Feld ist eines zu viel, wenn es keine verantwortliche Person, keine Definition und keinen Bericht oder keine Automatisierung hat, die es liest. Prüfen Sie Füllraten und Nutzung jedes Quartal und archivieren Sie, was den Test nicht besteht.